Weder Terraform noch Ansible: Wie UhuruTec uCloud ausbringt und konfiguriert
Terraform und Ansible waren nie Konkurrenten
Wer beide Werkzeuge gegenüberstellt, vergleicht Werkzeuge mit zwei unterschiedlichen Aufgaben. Über Jahre wurden sie deshalb gemeinsam und nicht alternativ eingesetzt.
- Terraform erstellt Infrastruktur. VMs, Netzwerke, Load Balancer und auf Wunsch auch Kubernetes-Cluster. Am Ende steht eine Infrastruktur, auf der weitere Komponenten ausgebracht werden können.
- Ansible konfiguriert diese Infrastruktur und bringt Anwendungen darauf aus. Pakete werden installiert, Konfigurationsdateien geschrieben und Dienste gestartet.
Das eine baut das Haus, das andere richtet es ein.
Die interessante Frage ist deshalb nicht, welches der beiden Werkzeuge gewinnt, sondern welche Komponenten diese beiden Aufgaben in einem cloud-nativen Ansatz übernehmen.
Zwei Aufgaben, zwei cloud-native Werkzeuge
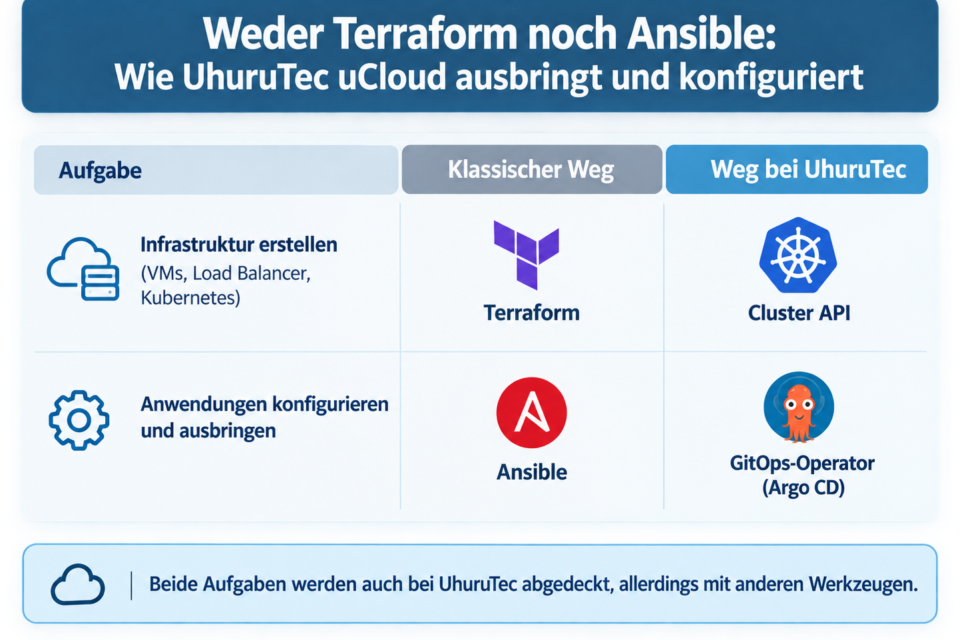
Auch bei UhuruTec werden beide Aufgaben abgedeckt, allerdings mit anderen Werkzeugen.
| Aufgabe | Klassischer Weg | Cloud-native bei UhuruTec |
|---|---|---|
| Infrastruktur erstellen (VMs, Load Balancer, Kubernetes) | Terraform | Cluster API |
| Anwendungen konfigurieren und ausbringen | Ansible | GitOps-Operator (Argo CD) |
Wie läuft das in der Praxis ab?
Am Anfang steht ein Bootstrap. Dieser lässt sich nicht vollständig vermeiden: Irgendwo muss die erste Ebene entstehen, auf der alles Weitere aufsetzt. Ist dieser Schritt einmal abgeschlossen, verändert sich die Arbeitsweise grundlegend.
Wer Infrastruktur benötigt, definiert beispielsweise ein Kubernetes-Cluster. Kubernetes-as-a Service wird deklarativ über die Cluster API bereitgestellt. Im Ergebnis übernimmt es diese Aufgabe, wofür sonst eine Terraform-Konfiguration zuständig wäre. Der Unterschied liegt darin, wo die Bereitstellung stattfindet: Sie wird als Kubernetes-Ressource innerhalb des Clusters definiert und verwaltet und nicht durch ein externes Werkzeug mit eigenem State. Ab diesem Punkt übernimmt der GitOps-Operator. Er liest den gewünschten Zustand aus einem Git-Repository und bringt die Anwendung als Kubernetes-Ressourcen in das Cluster. Damit übernimmt er die Rolle, die klassischerweise Ansible innehatte.
Der Sollzustand liegt dabei versioniert in Git. Er ist für die Beteiligten nachvollziehbar, kann überprüft und im Review kommentiert werden, anstatt in einer Sammlung von Playbooks zu liegen, die zu einem bestimmten Zeitpunkt manuell ausgeführt werden muss.
Die Container-Runtime übernimmt, was vorher Betriebssystem-Konfiguration war
Ein Beispiel aus dem klassischen Betrieb: Zunächst wird eine VM bereitgestellt. Anschließend wird darauf mit Ansible ein NGINX konfiguriert, Verzeichnisse werden angelegt, eine Konfigurationsdatei wird geschrieben, der Dienst gestartet und die Anwendung dahinter ausgebracht. Gearbeitet wird dabei auf Ebene des Betriebssystems.
Cloud-native wird ein Kubernetes-Cluster vorausgesetzt und die Anwendung als Deployment oder StatefulSet bereitgestellt. Das Betriebssystem spielt auf dieser Ebene keine Rolle mehr. Damit entfällt nicht nur ein Werkzeug. Auch der Konfigurationsdrift zwischen Maschinen wird reduziert. Es verschwindet auch der Konfigurationsdrift zwischen Maschinen und mit ihm der Satz „auf dem einen Node ist es aber anders“, den man bei jeder länger gewachsenen gewachsenen Betriebsumgebungen schon einmal gehört hat.
Kurzer Einschub: GitOps-Operator ist nicht gleich Kubernetes-Operator
Beide Begriffe enthalten „Operator“, was regelmäßig zu Missverständnissen führt, auch innerhalb eingespielter Teams.
Kubernetes-Operator ist der Oberbegriff. Ein Operator arbeitet mit Kubernetes-Ressourcen, häufig auch mit selbst definierten Ressourcen, und reagiert auf deren Zustand. Ein typisches Beispiel ist ein Operator, der Node-Objekte im Cluster beobachtet und handelt, sobald ein Node hinzukommt oder ausfällt.
Der GitOps-Operator ist ein Spezialfall, beziehungsweise eine Untermenge davon. Argo CD arbeitet mit seiner eigenen Custom Resource Application, generiert daraus beispielsweise ein Helm-Deployment und bringt das Ergebnis in das Cluster.
Auf ein Node-Ereignis kann Argo CD nicht reagieren und das ist auch nicht seine Aufgabe.
Wer beide Begriffe gleichsetzt, erwartet vom GitOps-Operator Funktionen, die er strukturell nicht leisten kann, und sucht die Ursache anschließend an der falschen Stelle.
Was das für uCloud bedeutet
uCloud wird als ein einziges Helm-Chart ausgeliefert. Darin liegt für jedes Teilprodukt eine eigene Argo-CD-Applikation, die wiederum das Helm-Chart des jeweiligen Produkts verwendet. Argo CD selbst bringt die Charts aus und hält sie auf dem gewünschten Stand. Praktisch bedeutet das: Alle Komponenten, die eine Cloud-Plattform benötigt, lassen sich in einem Schritt installieren. Was anschließend im Cluster läuft, ist zuvor als deklarativer Zustand in Git beschrieben. Ein Rollback wird damit zu einem Revert. Und wer eine zweite Umgebung aufbaut, muss dafür kein Betriebswissen aus den Köpfen der Beteiligten rekonstruieren.
Betrieben wird die Plattform von einem eigenen Management-Cluster auf separater Hardware. Dieses ist bewusst von der Cloud-Plattform getrennt, die es verwaltet. Denn: Ein Werkzeug, das eine Plattform verwaltet, sollte nicht gemeinsam mit dieser Plattform ausfallen können.
Was bringt das im Betrieb?
Zwei bekannte Werkzeuge durch zwei Andere zu ersetzen, wäre für sich genommen kein Fortschritt. Der entscheidende Unterschied liegt darin, dass beide Aufgaben innerhalb derselben deklarativen Ebene umgesetzt werden. Der Sollzustand ist an einer zentralen Stelle definiert und nicht auf zwei unterschiedliche Systeme verteilt. Es gibt keinen Zeitpunkt mehr, an dem ein Playbook zwingend ausgeführt werden muss: Der Operator gleicht den tatsächlichen Zustand kontinuierlich mit dem gewünschten Zustand ab.
Wer wissen möchte, was in einer Umgebung läuft, kann den definierten Zustand im Repository nachvollziehen. Eine zweite Umgebung entsteht aus derselben Quelle und nicht aus einer Kopie, die anschließend manuell mit angepassten Variablen verändert werden muss.
Für souveräne Plattformen ist das mehr als eine Frage des Komforts. Wer gegenüber einem Prüfer nachvollziehbar belegen muss, welcher Zustand in einer Umgebung definiert ist und wie dieser versioniert wurde, kann auf das Repository und die dokumentierte Änderungshistorie zurückgreifen, anstatt den Zustand ausschließlich über Gespräche mit dem Betriebsteam rekonstruieren zu müssen.
Weiterführende Links: